Robots.txt Nedir, Nasıl Oluşturulur? Örnek Robots.txt Kodları
robots.txt, sitenizin kök dizininde (siteniz.com/robots.txt) duran ve arama motoru botlarına hangi sayfaları tarayıp hangilerini taramayacaklarını söyleyen düz bir metin dosyasıdır. Yeni bir site için çoğu zaman şu birkaç satır yeterlidir:
User-agent: *
Disallow:

Sitemap: https://www.siteniz.com/sitemap.xml
Bu kod tüm botların sitenin tamamını taramasına izin verir ve site haritanızın yerini gösterir. Aşağıda WordPress, e-ticaret ve yapay zeka botları için hazır örnek kodları, robots.txt’nin nasıl oluşturulup test edileceğini ve en sık yapılan hataları bulacaksınız.
- Yeri: Sitenin kök dizini; adı tam olarak
robots.txtolmalı. - Temel kurallar:
User-agent(hangi bot),Disallow(taranmasın),Allow(istisna),Sitemap(site haritası). - robots.txt dizine eklemeyi engellemez. Bir sayfayı arama sonuçlarından çıkarmak için noindex kullanın.
- Google
crawl-delayve robots.txt içindekinoindexkuralını desteklemez. - Test: Search Console > Ayarlar > robots.txt raporu.
robots.txt Dosyasının Yapısı
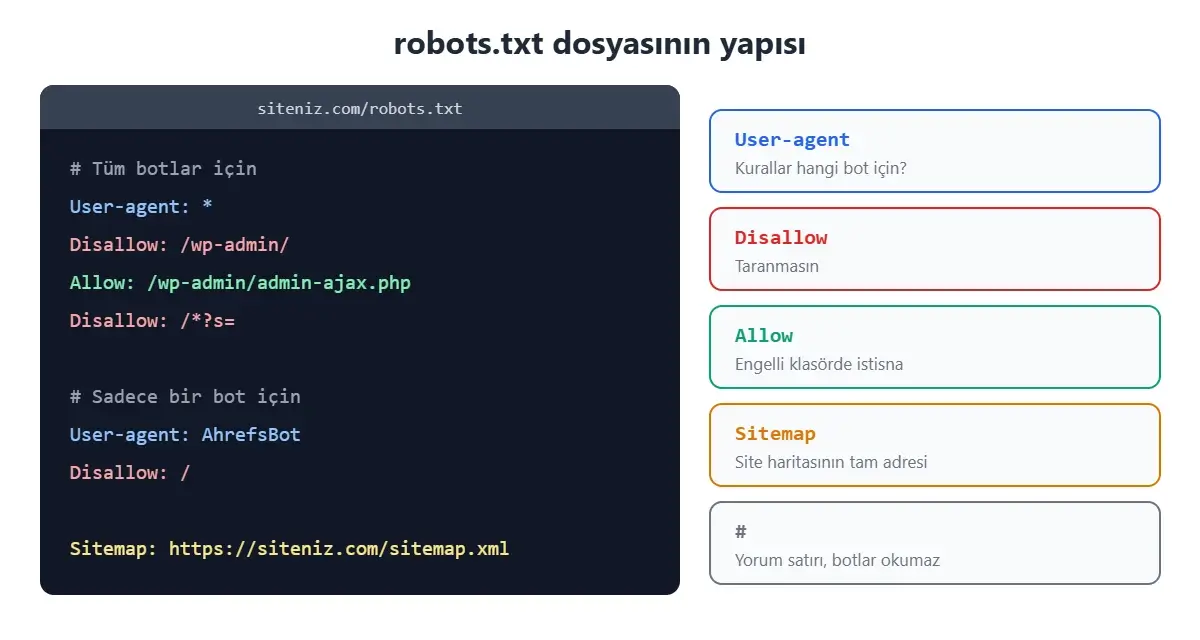
| Kural | Ne yapar? | Örnek |
|---|---|---|
User-agent |
Aşağıdaki kuralların hangi bot için geçerli olduğunu belirtir. * tüm botlar demektir. |
User-agent: Googlebot |
Disallow |
Taranmasını istemediğiniz yolu belirtir. Boş bırakılırsa her şeye izin verilir. | Disallow: /sepet/ |
Allow |
Engellenmiş bir klasörün içindeki belirli bir yola izin verir. | Allow: /wp-admin/admin-ajax.php |
Sitemap |
Site haritasının tam adresini gösterir. Birden fazla yazılabilir. | Sitemap: https://siteniz.com/sitemap.xml |
# |
Yorum satırı; botlar okumaz. | # Yönetim paneli |
Bilmeniz gereken kurallar:
- Büyük/küçük harf duyarlıdır:
Disallow: /Sepet/,/sepet/adresini engellemez. - Joker karakterler:
*herhangi bir karakter dizisi,$adresin sonu demektir.Disallow: /*.pdf$tüm PDF dosyalarını engeller. - En ayrıntılı kural kazanır: Google için hem Allow hem Disallow eşleşiyorsa, yolu daha uzun (daha ayrıntılı) olan kural uygulanır.
- Her bot kendi grubunu okur: Googlebot için ayrı bir grup yazdıysanız Googlebot
User-agent: *grubunu yok sayar. - Dosya UTF-8 olmalı ve Google’ın okuduğu boyut sınırı 500 KiB’dir.
robots.txt Nasıl Oluşturulur?
1. Elle oluşturma (her site için)
- Bilgisayarınızda Not Defteri gibi düz bir metin düzenleyici açın (Word kullanmayın).
- Aşağıdaki örneklerden sitenize uygun olanı yazın ve dosyayı UTF-8 kodlamasıyla
robots.txtadıyla kaydedin. - cPanel’deki Dosya Yöneticisi veya FTP ile sitenin kök dizinine (genellikle
public_html) yükleyin. - Tarayıcıda
siteniz.com/robots.txtadresini açarak dosyanın göründüğünü kontrol edin.
2. WordPress’te robots.txt oluşturma
WordPress, kök dizinde bir dosya yoksa otomatik olarak sanal bir robots.txt üretir. Düzenlemek için:
- Yoast SEO: Yoast SEO > Araçlar > Dosya düzenleyici menüsünden robots.txt oluşturup düzenleyebilirsiniz.
- Rank Math: Rank Math > Genel Ayarlar > robots.txt’yi düzenle bölümünden düzenlenir.
- Eklentisiz: Yukarıdaki elle oluşturma adımlarını izleyip dosyayı kök dizine yükleyin; gerçek dosya, sanal dosyanın yerine geçer.
3. Hazır e-ticaret altyapılarında
IdeaSoft, Ticimax, ikas, Shopify gibi altyapılar robots.txt dosyasını otomatik oluşturur. Bazıları panelden düzenlemeye izin verir; Shopify’da düzenleme tema dosyalarındaki robots.txt.liquid şablonuyla yapılır.
Örnek robots.txt Kodları
Tüm botlara tam izin (yeni siteler için)
User-agent: *
Disallow:

Sitemap: https://www.siteniz.com/sitemap.xml
WordPress için önerilen robots.txt
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/

Sitemap: https://www.siteniz.com/sitemap_index.xml
admin-ajax.php izni, bazı temaların ve eklentilerin ön yüzde çalışması için gereklidir. Site içi arama sonuçlarını engellemek, değersiz arama sayfalarının taranmasını önler.
E-ticaret siteleri için örnek
User-agent: *
Disallow: /sepet/
Disallow: /odeme/
Disallow: /hesabim/
Disallow: /*?siralama=
Disallow: /*?filtre=

Sitemap: https://www.siteniz.com/sitemap.xml
Sepet, ödeme ve üyelik sayfalarının taranmasına gerek yoktur. Sıralama ve filtre parametreleri ise aynı ürünlerin binlerce farklı adresle taranmasına yol açar. Parametre adlarını kendi altyapınıza göre değiştirin.
Tüm siteyi engellemek (geliştirme ortamları için)
User-agent: *
Disallow: /
Bu kodu yalnızca test veya geliştirme sitelerinde kullanın. Canlı sitede kalırsa site arama sonuçlarından tamamen düşer (aşağıdaki Kappa örneğine bakın).
Belirli bir klasörü engelleyip içindeki bir sayfaya izin vermek
User-agent: *
Disallow: /ozel/
Allow: /ozel/basin-bulteni.html
Belirli dosya türlerini engellemek
User-agent: *
Disallow: /*.pdf$
Disallow: /*.docx$
Sadece Googlebot için kural yazmak
User-agent: Googlebot
Disallow: /test/

User-agent: *
Disallow:
SEO araçlarının botlarını engellemek
Rakiplerin bağlantı ve içerik analizini zorlaştırmak veya sunucu yükünü azaltmak için SEO araçlarının botları engellenebilir. Bu sitenin kendi robots.txt dosyası da Ahrefs, Semrush ve arşiv botlarını bu şekilde engelliyor:
User-agent: AhrefsBot
Disallow: /

User-agent: SemrushBot-SI
Disallow: /

User-agent: archive.org_bot
Disallow: /

Sitemap: https://www.anilcagliyan.com/sitemap_index.xml
Bu botları engellemek Google sıralamasını etkilemez; sadece o araçların sitenizi taramasını önler.
Yapay Zeka Botları İçin robots.txt
ChatGPT, Claude, Perplexity ve Gemini gibi yapay zeka servisleri de web’i tarar. Hangi botların açık kalması gerektiğine platform bazında karar vermek için GEO danışmanlığı sayfasındaki tabloya bakabilirsiniz. Bu botların iki türü vardır ve kararınızı ayrı ayrı vermeniz gerekir:
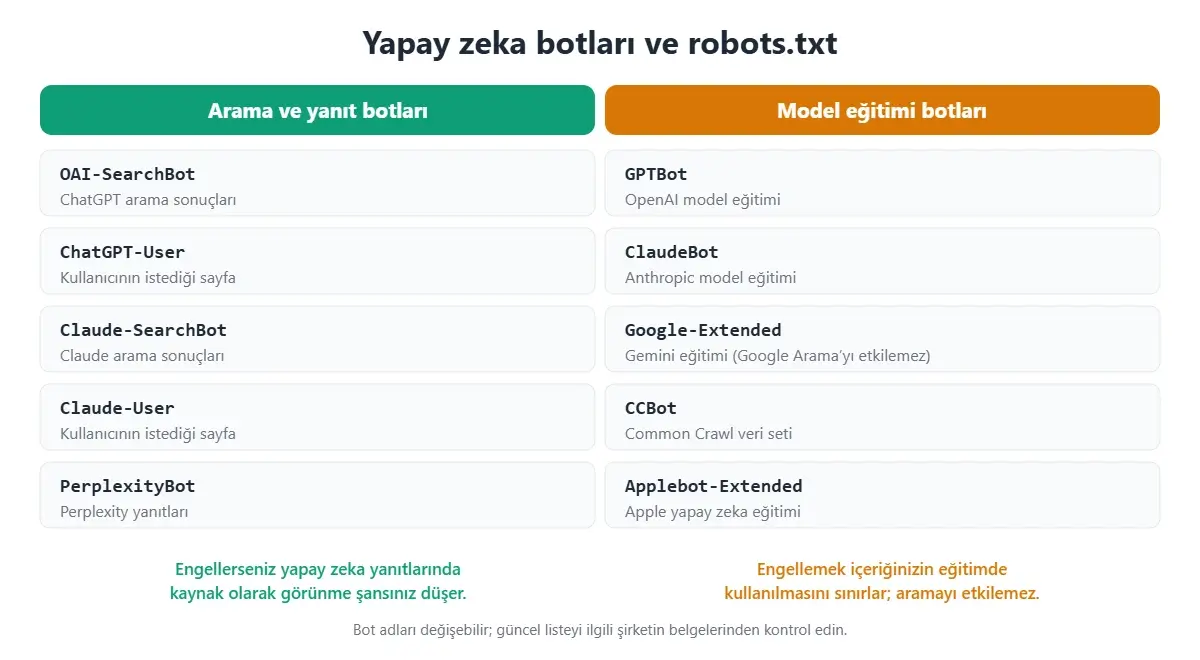
| Bot | Şirket | Ne için tarar? |
|---|---|---|
OAI-SearchBot |
OpenAI | ChatGPT arama sonuçlarında göstermek için |
ChatGPT-User |
OpenAI | Kullanıcı ChatGPT’den bir sayfayı açmasını istediğinde |
GPTBot |
OpenAI | Model eğitimi |
Claude-SearchBot |
Anthropic | Claude arama sonuçları |
Claude-User |
Anthropic | Kullanıcı Claude’dan bir sayfayı açmasını istediğinde |
ClaudeBot |
Anthropic | Model eğitimi |
PerplexityBot |
Perplexity | Perplexity yanıtlarında göstermek için |
Google-Extended |
Gemini modellerinin eğitimi; Google Arama sıralamasını etkilemez | |
CCBot |
Common Crawl | Birçok yapay zeka modelinin kullandığı açık veri seti |
Yapay zeka yanıtlarında kaynak olarak görünmek istiyorsanız arama botlarını engellemeyin. İçeriğinizin model eğitiminde kullanılmasını istemiyorsanız sadece eğitim botlarını engelleyin:
# Yapay zeka eğitim botlarını engelle
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /

# Arama ve yanıt botlarına izin ver
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Disallow:
Bot adları zamanla değişebilir; güncel listeyi her şirketin kendi belgelerinden kontrol edin.
robots.txt Dizine Eklemeyi Engeller mi?
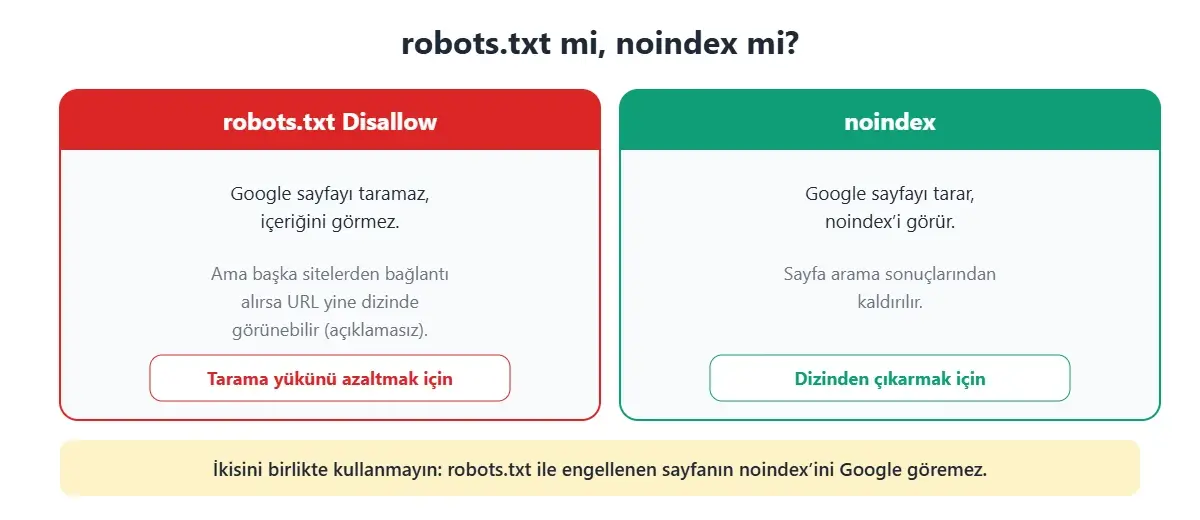
Hayır. robots.txt yalnızca taramayı engeller. Google engellenmiş bir sayfanın içeriğini göremez, ama o sayfaya başka sitelerden bağlantı verilmişse adresi yine de arama sonuçlarında açıklamasız olarak gösterebilir. Search Console’da bu durum “robots.txt tarafından engellenmiş olsa da dizine eklendi” uyarısıyla görünür.
Bir sayfayı arama sonuçlarından çıkarmak istiyorsanız sayfaya noindex ekleyin ve sayfanın taranmasına izin verin. robots.txt ile engellenen sayfadaki noindex’i Google göremez. Diğer robots meta kuralları için: indexifembedded ve diğer robots kuralları.
robots.txt Nasıl Test Edilir?
- Tarayıcıda açın:
siteniz.com/robots.txtadresi 200 durum koduyla açılmalı ve içerik doğru görünmeli. - Search Console robots.txt raporu: Ayarlar > robots.txt bölümünde Google’ın dosyanızı en son ne zaman okuduğunu, hata ve uyarıları görürsünüz. Dosyayı güncellediyseniz buradan yeniden taranmasını isteyebilirsiniz. (Eski “robots.txt Test Aracı” 2023’te kaldırıldı.)
- URL Denetleme aracı: Belirli bir sayfanın robots.txt ile engellenip engellenmediğini URL Denetleme aracında görebilirsiniz.
Google robots.txt dosyanızı genellikle 24 saate kadar önbellekte tutar; değişikliklerin etkili olması bir gün kadar sürebilir.
Örnek Vaka: Kappa’nın robots.txt Hatası
2022 Survivor yarışmasının sponsoru Kappa, yarışmanın başladığı ilk günlerde büyük bir hata yaptı. Sitelerindeki robots.txt dosyası tüm botların siteye girmesini engelliyordu. Televizyondaki yoğun reklama rağmen marka Google’da aranınca site sonuçlarda doğru şekilde görünmedi ve reklamın yarattığı arama trafiğinin bir kısmı başka sitelere gitti.
Kappa’nın o dönemde kullandığı robots.txt:
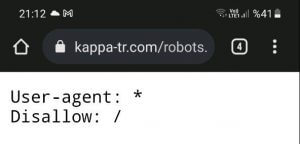
Hata bir süre sonra fark edilip düzeltildi. Ders açık: robots.txt’de tek bir satır (Disallow: /) tüm siteyi aramadan silebilir. Özellikle site taşıma ve tasarım değişikliklerinden sonra, test sitesindeki dosyanın canlıya taşınıp taşınmadığını mutlaka kontrol edin.
En Sık Yapılan robots.txt Hataları
- Test sitesindeki
Disallow: /satırını canlıya taşımak. - CSS ve JavaScript dosyalarını engellemek: Google sayfayı doğru görüntüleyemez ve mobil uyumluluğu yanlış değerlendirebilir.
- Dizinden çıkarmak için robots.txt kullanmak: Bunun için noindex gerekir.
- robots.txt’ye
noindexveyacrawl-delayyazmak: Google ikisini de desteklemez. Tarama hızı hakkında: crawl delay nedir? - Gizli sayfaları robots.txt’de listelemek: Dosya herkese açıktır; gizli yönetim adreslerinizi buraya yazmak onları ifşa eder. Gizli sayfaları şifreyle koruyun.
- Büyük/küçük harf ve sondaki eğik çizgiyi unutmak:
/Blogile/blogfarklıdır. - Dosyayı yanlış yere koymak: robots.txt sadece kök dizinde çalışır; alt klasördeki dosya okunmaz.